こんにちは。ACS事業部の越川です。
- 仮説を立てました
- 結果
- macca(ローカル音楽プレイヤー)
- totta(本をLLMに読ませるアプリ)
- 検証結果
- 速さの正体
- Copilot でも同じか試しました
- 作って終わりにはなりませんでした
- AIで作ったものと、AIが作ったもの
- まとめ
- 参考
- ACS 事業部のご紹介
仮説を立てました
「AIを使えば欲しいツールはすぐできる」
この言い方は珍しくありません。ただ自分で確かめていないことを確かめた気になるのが嫌でした。だから実際に作って検証しました。
検証の条件は3つ置きました。
- 本業の主言語ではない言語を選ぶ
- 既存ツールの模倣ではなく、自分が本当に欲しいものを作る
- 動くところで止めず、配布できる形まで持っていく
2番目が肝でした。サンプルアプリを作っても「すぐできた」としか言えません。毎日使いたいものでなければ判定できないからです。
題材は2つです。ローカルの音楽プレイヤーと、本をスキャンしてLLMに読ませるアプリです。どちらも個人のMacで個人リポジトリとして作りました。実装にはClaude Codeを使っています。
結果
| macca | totta | |
|---|---|---|
| 何を作ったか | ローカル音楽プレイヤー | 本の見開きをOCR付きPDFにするアプリ |
| 言語 | Go + JavaScript | Swift |
| 期間 | 5日間 | 1日 |
| コミット数 | 142 | (完成後に公開) |
| 配布形態 | macOS / Windows / Linux | macOS / iOS |
| ライセンス | MIT | MIT |
仮説は成立しました。ただし成立した理由が、当初思っていたものと違いました。そこが本題です。
macca(ローカル音楽プレイヤー)
https://github.com/koshikawa-masato/macca
作った理由
Apple純正アプリでローカルファイルとサブスクを同時に管理するのが厳しくなっていました。iTunes Matchの同期でファイルが壊れることがあり、非圧縮や可逆の音源が数百GBあると管理そのものが破綻します。
欲しかったのは「フォルダをそのまま読んで鳴らすだけ」のプレイヤーでした。Swinsian や foobar2000、Doppler、Navidrome、Plexamp など近い既製品はあります。ただしどれもライブラリを取り込む思想でした。ファイルとフォルダを唯一の正とする最小構成が欲しかったので作りました。
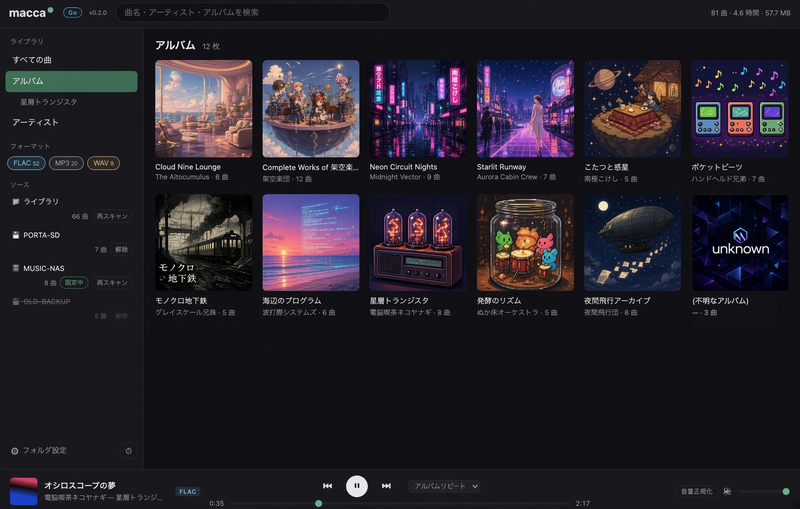
設計原則を先に決めました
READMEに5つ書いています。
- 再生に特化する。管理機能より再生体験を優先する
- 軽量に保つ。依存ゼロで、要らないものを足さない
- 再生の邪魔をしない。UIも処理も、いま鳴っている音を妨げない
- 音質に妥協しない。ビット正確なデコードで、不要なリサンプリングをしない
- 先人の真似をしない。既存プレーヤの再現ではなく、ファイルとフォルダを正とする最小構成を貫く
この5番目が全体を決めました。既製品の機能表を眺めて埋めていく作り方をやめる、という宣言です。
実装で判断したこと
再生エンジンを自作しました <audio>タグに任せると、ギャップレス再生とサンプルレートの制御ができません。Web Audio APIベースで組み、AudioContextを音源のサンプルレートに合わせて生成しています。44.1kHzの音源が不用意に48kHzへ変換されて劣化するのを避けるためです。
ALACはApple公式デコーダをWASM化して同梱しました Appleがオープンソース化した公式実装(Apache 2.0)を使っています。サイズは16KBです。AIFFは実質ビッグエンディアンPCMなので、純JSでデコードしています。ffmpegに依存せず、モダンブラウザだけでMP3・AAC・ALAC・AIFF・FLAC・WAVが鳴ります。
音量正規化は線形ゲインだけにしました ITU-R BS.1770(EBU R128やReplayGain 2.0と同じK特性ラウドネス測定)の実測値で曲間の音量差を揃えます。コンプレッサやリミッタは通しません。音を揃えるために音質を落とすのは本末転倒だからです。ファイルにも書き込みません。
曲全体を展開しません 受信しながら再生を始め、再生位置の周辺だけをデコードしてすぐ解放します。15分を超えるトラックは全体デコードをやめてストリーミング再生に切り替えます。
結果として、実測値はこうなりました。約620曲・27時間・11GBのライブラリをSDカードから配信し、FLACをストリーミング再生している状態です。
| 項目 | 実測値 |
|---|---|
| クリックから再生開始まで | 21〜128ms |
| サーバ常駐メモリ(RSS) | 約20MB(CPU 0.1%) |
| ブラウザタブのJSヒープ | 約75MB |
| 保持するデコード済みPCM | 再生位置の周辺30〜45秒分のみ |
メモリ使用量が曲の長さやライブラリの規模にほぼ依存しません。この数字はアプリ内のボタンからいつでも表示できるようにしてあります。
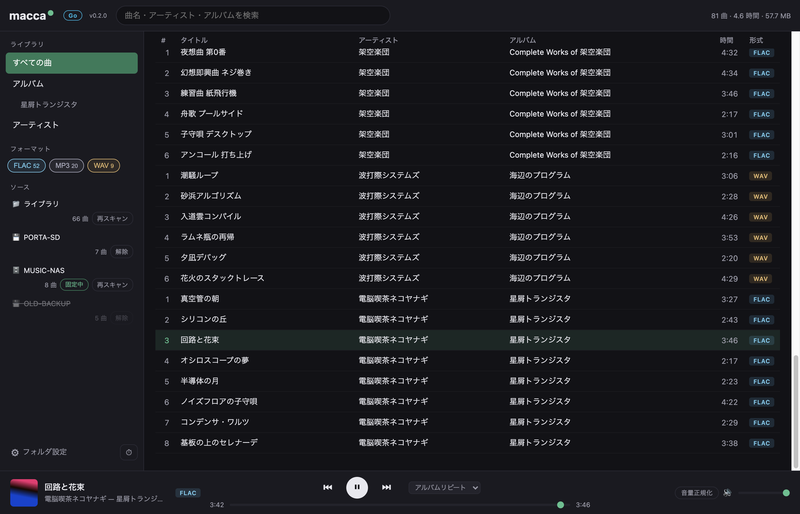
載せなかった機能
ここが一番時間をかけたところです。READMEに「やらないこと」として理由つきで書いています。
- タグ編集。ファイルに一切書き込みません。タグ整理はbeetsやMp3tagという専用ツールの領域です
- プレイリスト。アルバムで聴くためのプレーヤなので、再生単位はフォルダとアルバムで完結させます
- ライブラリ全体のシャッフル。同上です
- 独自データベースやファイルの取り込み。フォルダ構成が唯一の正です
- ネットワーク経由での視聴。できないのではなく、やりません
サーバは127.0.0.1にのみバインドしています。LANやインターネットには公開しません。待ち受けを広げると認証も暗号化もない口が開きます。セキュリティホールの拡大とライブラリ情報の漏洩につながるので載せません。
totta(本をLLMに読ませるアプリ)
https://github.com/koshikawa-masato/totta
作った理由
手元の本をLLMに読ませたいだけです。
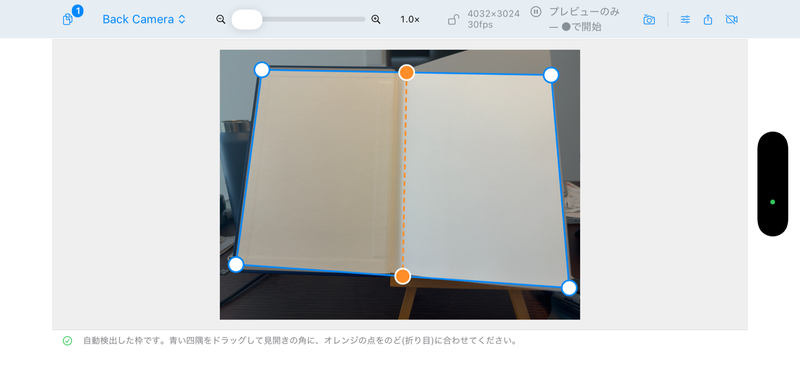
固定したカメラの前で本の見開きを開いて止め、めくります。静止したページを自動で切り出してOCRテキスト付きのPDFにします。macOSとiOSの両方で動きます。
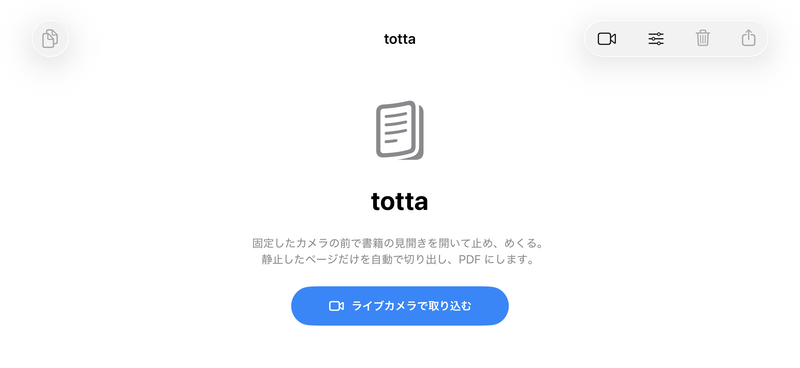
LLMに渡す前提から逆算しました
設計目標が普通のスキャナアプリと違います。Claude にPDFを添付する上限が32MBなので、既定でその範囲に収まるようにしてあります。
そこから逆算して、既定値はグレースケール・長辺2400px・JPEG品質0.75になりました。実測(14ページ)ではこうです。
| 設定 | サイズ |
|---|---|
| 撮影したまま | 29.4MB |
| 3000px | 18.6MB |
| 2400px | 12.6MB |
| 2000px | 9.2MB |
| 1600px | 6.2MB |
2400pxでも本文は問題なく読めます。
グレースケール化には落とし穴がありました。CoreImageのphotoEffectMonoは見た目がグレーになるだけで、中身はRGBのままなのでサイズが落ちません。真のDeviceGray 1チャンネルへ変換する必要があります。実測でカラー45.2MB、RGBのままグレーが35.8MB、真のグレーが35.2MBでした。
OCRは縮小前のフル解像度で実行してから縮小します。 認識精度を落とさずにサイズだけ下げるためです。実写のページで平均信頼度0.87、本文段落は1.00程度になりました。
見開きは中央で割ります。 見開きのまま1ページにすると、pdfminerのような外部パーサのレイアウト解析が左右ページの行を交互に混ぜることがあります。LLMに読ませる前提では致命的なので、既定で分割しています。
メモリの設計
PDF書き出しは1ページずつ書き足し、そのページの一時画像をautoreleasepoolで都度解放しています。4032×3024の見開きを流したベンチマークで、4ページから64ページまで増やしてもピークは215MBから540MBで頭打ちになりました。全ページを同時展開すると1ページ46MB×ページ数になるので、ギガ単位に膨れます。
データを残さない設計
- カメラ映像は録画も一時保存もしません。動画ファイルの読み込み機能もありません
- 取り込んだページはメモリ上にだけ保持し、ディスクに書くのは最終PDFだけです
- PDF保存が完了した時点で途中データはすべて破棄します
- OCRはすべて端末内で処理し、外部サービスには送りません
失敗した話
本を撮ると指が写り込みます。消す機能を作りました。動かしたら、指ではなくページの方が消えました。
原因は色でした。クリーム色の本文用紙は肌色と色相・彩度が近く、色だけで判定するとページ本体を「指」とみなして消してしまいます。
作り直した判定は、次の5つをすべて満たす領域だけを消します。
- Visionで手が検出され、その関節位置を含む連結領域である
- 紙より彩度が高い(紙の色は画像から推定する)
- 肌色の色相である
- 縦横どちらかがページの半分未満の細長い形である
- 全体の被覆率が上限(既定10%)以下である
ひとつでも外れたら何も消しません。既定はオフにしました。
そして、文字の上にかかった指は復元しません。 生成AIで文字を捏造しない方針だからです。読めない箇所は読めないまま残します。それが元の本の内容だからです。
検証結果
仮説「AIを使えば欲しいツールはすぐできる」は成立しました。
本業の主言語ではないGoとSwiftで、実際に動くものができました。maccaは5日間で142コミット、3つのOS向けに配布できる形になっています。tottaは1日でmacOSとiOSのアプリになりました。
数年前の自分に「知らない言語でiOSアプリを1日で作れるか」と聞いたら、無理だと答えたはずです。そこは確かに変わりました。
ただし「すぐできた」の中身は想定と違いました。
速さの正体
速かったのはAIの生成速度ではありませんでした。欲しいものが自分の中で明確だったことが速さの正体です。
この記事で挙げた判断を並べてみます。
macca では、
- 先人の真似をしない
- 音を揃えるためにコンプレッサは通さない
- ネットワークには公開しない。できないのではなく、やらない
- タグ編集は載せない。専用ツールの領域だから
totta では、
- 32MB以内に収める。Claudeに添付する上限だから
- OCRは縮小前に実行する。精度を落とさないため
- 文字の上の指は復元しない。捏造しないため
これらは全部AIに聞いても出てきません。判断の材料は私の生活と用途の中にしかありません。「音楽をどう聴きたいか」「本をLLMに何のために読ませたいか」は私の側が持っています。
仕様が自分の中にあったからAIは速く実装できました。仕様が曖昧なままAIに投げていたら話は違います。それらしいものはできても使い続けるものにはならなかったはずです。
だから仮説は、正確にはこう書き換わります。
欲しいものが明確なら、AIを使えばそれはすぐできる
条件はAIの側ではなく自分の側にありました。
Copilot でも同じか試しました
ここまで Claude Code の話をしてきました。ツールに依存する結論なのかを確かめたかったので、GitHub Copilot CLI でも同じことを試しました。
題材は macca の AIFF デコーダです。実物と同じ用途の仕様文を書いて渡しました。
AIFF ファイル(ビッグエンディアンPCM)を JavaScript でデコードする関数を書いてください。ブラウザで動く純JS実装で、外部ライブラリは使いません。COMM/SSND チャンクを読み、16bit/24bit に対応し、Float32Array を返してください。
結果です。
| 行数 | AI Credits | 所要時間 | |
|---|---|---|---|
| Claude Sonnet 5 | 239 | 17.5 | 1分6秒 |
| GPT-5.6 Sol | 145 | 9.53 | 45秒 |
| macca の実物 | 95 |
どちらも動くコードが出ました。ただし実物より長く、対応している形式は少なくなりました。
| 対応項目 | Claude Sonnet 5 | GPT-5.6 Sol | macca の実物 |
|---|---|---|---|
| 16bit / 24bit BE | あり | あり | あり |
| 8bit / 32bit | なし | なし | あり |
sowt(16bit LE) |
なし | なし | あり |
fl32 / fl64 |
なし | なし | あり |
| AIFC 形式 | 検出のみ | なし | あり |
| 80bit拡張浮動小数点のサンプルレート | あり | なし | あり |
| チャンクの偶数境界パディング | あり | なし | あり |
| 壊れたファイルへの防御 | なし | なし | あり |
差が出た理由は明確です。私が渡した仕様が「16bit/24bit に対応」だったからです。両モデルは仕様どおりに作りました。
実物には sowt や fl64 への対応が入っています。手元の音源に再生できないファイルがあって初めて必要だと分かりました。壊れたファイルへの防御も同じです。仕様に書かなければ出てきません。
ツールを変えても結論は同じでした。出てくるものの質は渡す仕様の細かさで決まります。
なお Copilot CLI では既定が Claude Sonnet 5 で、Claude Opus 4.8 や GPT-5.6 系も選べます。これは私の個人アカウントで確認した時点の状態です。組織で契約している場合は管理者の設定によって選べるモデルが変わります。
作って終わりにはなりませんでした
もうひとつ、予想と違ったことがあります。
maccaは主開発を終えたあと、約1週間後に3コミットしています。メニューバーの「再生中」表示をクリックしたときの挙動と、複数アーティストのアルバムの並び順を直しました。
使っていて気づいたから直しただけです。「AIで量産して捨てる」作り方ではありません。自分が毎日使うものだから戻ってきます。10リリースを切って3つのOS向けに配布しているのも自分で使うために必要だったからです。
検証の条件に「配布できる形まで持っていく」を入れたのは正解でした。動くだけで止めていたら、この差は見えませんでした。
AIで作ったものと、AIが作ったもの
この2つはAIで作りました。ただしAIが作ったものではありません。
maccaのREADMEには「やらないこと」が理由つきで並んでいます。tottaには「文字を捏造しない」という方針があります。どちらも機能を足す方向ではなくあえて足さない方向の判断です。
AIに丸投げすると、この「あえて載せない」が出てきません。求めれば足してくれるからです。何を載せないかを決めるのは、そのツールを毎日使う人間の側の仕事でした。
ACS事業部のAIスタイルブックに「丸投げせず、自らの意思を込める」という一節があります。今回の検証で言えば、意思にあたるものが設計原則と「やらないこと」でした。それを持っていたから、AIは速く動けたのだと思います。
まとめ
「AIを使えば欲しいツールはすぐできる」を自分で検証しました。
- 本業でない言語(Go / Swift)で、5日と1日で動くものができた
- 配布形態(3つのOS、10リリース)まで到達した
- 仮説は成立した。ただし成立の条件は自分の側にあった
- 速さの正体はAIの生成速度ではなく、欲しいものが明確だったこと
- あえて載せない判断は、AIからは出てこなかった
- GitHub Copilot CLI で同じ仕様を渡しても結論は変わらなかった
AIの使い方が分かってくると、関心は「どう使うか」から「何を作るか」に移ります。移ったあとに必要になるのは、AIの知識ではなく、自分が何を欲しいと思っているかの解像度でした。
両方ともMITライセンスで公開しています。動かしてみたい方はどうぞ。
なお、この2つの実装にはClaude Codeを使っています。比較検証には GitHub Copilot CLI 1.0.80 を使いました。設計判断と検証は私が行い、記事の内容もすべて自分で確認したものです。
参考
記事中の実測値は、いずれも自分の環境で計測したものです。コミット数やリリース数は GitHub API から取得しました。
- macca(MIT License) https://github.com/koshikawa-masato/macca
- totta(MIT License) https://github.com/koshikawa-masato/totta
- ITU-R BS.1770(音量正規化に使用したラウドネス測定方式。EBU R128 / ReplayGain 2.0 と同系) https://www.itu.int/rec/R-REC-BS.1770/en
- Apple ALAC(Apache License 2.0。WASM 化して同梱した公式デコーダ) https://github.com/macosforge/alac
- Apple Vision Framework(端末内 OCR と書類セグメンテーションに使用) https://developer.apple.com/documentation/vision
- beets(タグ編集を任せる専用ツールとして参照) https://beets.io/
- Mp3tag(同上) https://www.mp3tag.de/
- GitHub Copilot CLI について https://docs.github.com/en/copilot/concepts/agents/about-copilot-cli
- GitHub Copilot for Xcode の Agent Mode https://devblogs.microsoft.com/xcode/github-copilot-for-xcode-unlocking-agentic-power-for-apple-developers/
ACS 事業部のご紹介
私の所属する ACS 事業部では、開発者ポータル Backstage、Azure AI Service などを活用し、Platform Engineering + AI の推進・内製化を支援しています。
www.ap-com.co.jp www.ap-com.co.jp www.ap-com.co.jp
また、GitHub パートナーとしてお客様に GitHub ソリューションの導入支援を行っています。 GitHub Copilot などのトレーニングなども行っておりますので、ご興味を持っていただけましたらぜひお声がけいただけますと幸いです。
一緒に働いていただける仲間も募集中です! ご興味持っていただけましたらぜひお声がけください。
※求人名の冒頭に【ACSD】と入っている求人が当事業部の求人です
